Open LLM สัญชาติไทย เข้าใจไทยทุกมิติ
โมเดลภาษาขนาดใหญ่แบบ multimodal ที่เข้าใจทั้ง ข้อความ ภาพ และเสียง ภาษาไทย พัฒนาโดย NECTEC สวทช. เปิดให้ทุกคนใช้งานและต่อยอดได้ฟรี


พิมพ์ พูด ส่งรูป ก็เข้าใจ
ไม่ต้องสลับหลายเครื่องมือ เพราะ Pathumma อ่านทั้งข้อความ รูปเอกสาร และเสียงพูดภาษาไทยได้ในโมเดลเดียว
Text
ตอบคำถาม สรุปความ ร่างเอกสาร แปลภาษา และทำ RAG บนความรู้ภาษาไทยได้อย่างเป็นธรรมชาติ
Vision
อ่านข้อความในภาพ (OCR) เข้าใจตาราง ฟอร์ม ใบเสร็จ และอธิบายเนื้อหาภาพเป็นภาษาไทย
Audio
ถอดเสียงพูด (ASR) เข้าใจบทสนทนา และสรุปสาระสำคัญจากไฟล์เสียงประชุมหรือคลิปได้ทันที
โมเดลที่เปิดให้ใช้งาน
ทุกโมเดลปล่อย open weights ดาวน์โหลดและ fine-tune ต่อได้ฟรีบน Hugging Face

ทดลองใช้ Pathumma
เลือกประเภทงานและตัวอย่างคำสั่ง เพื่อดูผลลัพธ์ภาษาไทยจากแต่ละโมเดล
สรุปข้อความนี้ให้เหลือหนึ่งประโยค: หน่วยงานภาครัฐเริ่มนำ AI มาช่วยตรวจเอกสารภาษาไทย เพื่อลดเวลาทำงานซ้ำและให้เจ้าหน้าที่มีเวลาดูแลงานที่ต้องใช้การตัดสินใจมากขึ้น โดยข้อมูลทั้งหมดต้องจัดเก็บภายในประเทศ
ตัวอย่างจำลองเพื่อแสดงรูปแบบการทำงาน เชื่อมต่อโมเดลจริงได้ผ่าน API หรือ Hugging Face
เครื่องมือที่สร้างบน Pathumma
แอปที่ NECTEC ทำไว้ให้ใช้จริงแล้ว ไม่ต้องเขียนโค้ดเอง เข้าไปลองได้เลย
สื่อเผยแพร่
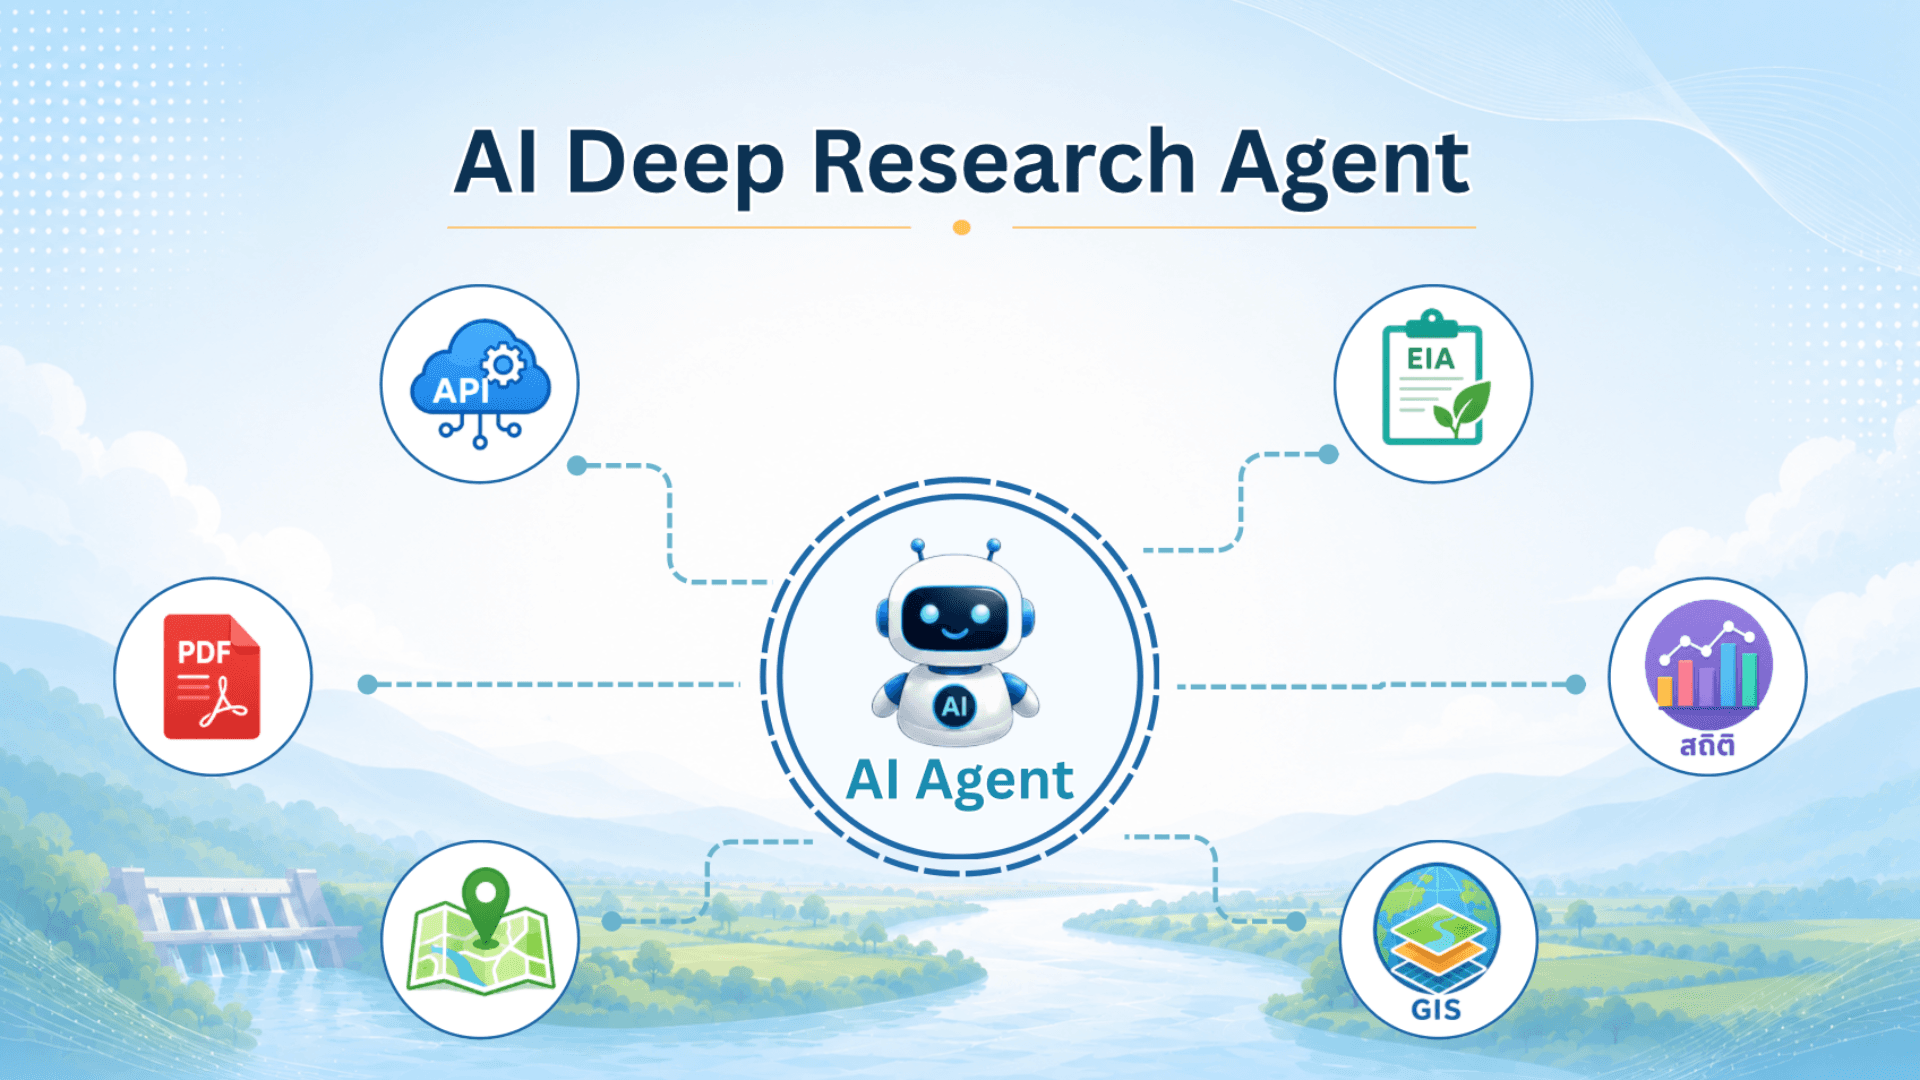
รวบรวมสื่อประชาสัมพันธ์และสื่อแนะนำการใช้งานของ Pathumma
ปัญญาประดิษฐ์สัญชาติไทย
เพื่อคนไทย
ชื่อ “ปทุมมา” มาจากดอกบัวสายพันธุ์ไทย สื่อถึงปัญญาที่งอกงามจากรากฐานของเราเอง Pathumma LLM พัฒนาโดย ศูนย์เทคโนโลยีอิเล็กทรอนิกส์และคอมพิวเตอร์แห่งชาติ (NECTEC) ภายใต้ สวทช. เพื่อให้ประเทศไทยมีโมเดลภาษาขนาดใหญ่ที่เข้าใจบริบท วัฒนธรรม และภาษาไทยอย่างแท้จริง
 Thai-first
ฝึกบนคลังข้อมูลภาษาไทยคุณภาพสูง
 Open
เปิด weights ให้ใช้และต่อยอดได้ฟรี
 Sovereign
เทคโนโลยีที่ไทยเป็นเจ้าของเอง
 Community
ขับเคลื่อนโดยชุมชนนักพัฒนาไทย
ข่าวสารและอัปเดต
ข่าว รางวัล และความเคลื่อนไหวล่าสุดของ Pathumma LLM